开个独立工位:Worktree 多会话隔离实战
约 14 分钟驭光者首发于微信公众号「羲和Lab」
从 stash 切换到并行上下文,一个人也能同时推进多个需求
阅读时长约12分钟 | 教程型 | 智能编码进化论 · 特别企划
本文是《智能编码进化论》系列第 08 篇(多会话与 CI/CD 实战)的延伸阅读。第 08 篇讲了并行策略全景——Worktrees、Desktop、Cloud、Agent Teams 四条路径,本文深挖 worktree 单点的工程化落地。
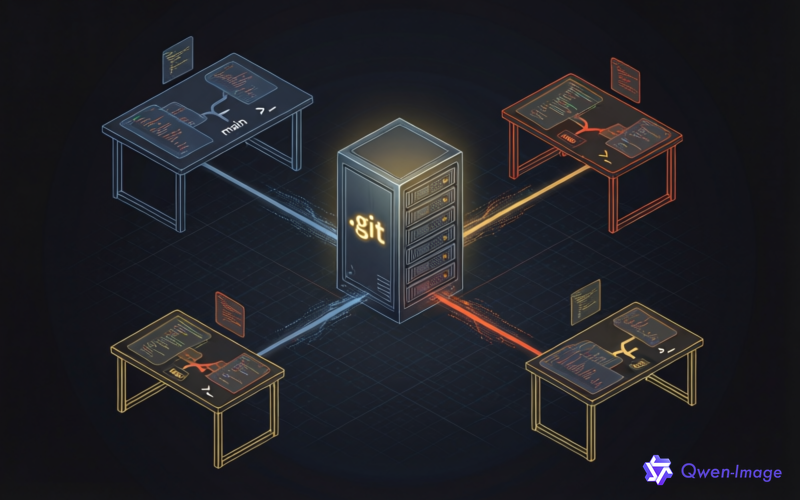
导读:一个人的"多任务串味"困境
需求 A 改到一半,产品插了一个紧急 bug。
你 git stash、切分支、修 bug、切回来——这套动作练了几百遍,闭着眼都能做。但如果你同时开着两个 Claude 会话呢?一个改需求 A,一个修 bug,两个会话盯着同一份代码——改了同一个文件,一个保存就把另一个的改动覆盖了。你还浑然不知,直到测试跑出来一堆莫名其妙的报错。stash 解决的是切换上下文,没解决并行上下文。你只有一个工位,再怎么熟练,也只能一个人坐。
更痛的场景:一个需求要改三个关联仓库,P1 的接口变了 P2 得跟着改,P2 改完知识库 K 还得同步更新。你在三个目录间反复 stash、checkout、pop,脑子成了栈——一打断就忘了压在哪层。你就是在三个工位之间跑来跑去,哪个都没做完。
如果你一个人带三个需求,每个需求改三套东西——你需要的不是更快的切换速度,而是更多的工位。
本文要讲的东西用一句话概括:git worktree 让一个仓库同时存在多个工作目录,每个目录独立改代码、独立跑构建、互不干扰。配上 Claude Code 的 --worktree 参数,一行命令就能开一张新工位。
读完你会得到:一张图看懂 worktree 原理、一张表判断你的项目该不该用、跨仓库并行推进需求的实战流程、五个我从真实项目中踩过的坑、以及一套可以直接写进 CLAUDE.md 的规范。读完你会看到:三个终端并排、三个仓库同名 worktree、一个人同时推进三个工程的真实画面。
一、worktree 是什么:共享 .git,独立工作区
想象你的项目是一间办公室。你只有一张桌子——项目主目录就是你的工位。不管多少需求、多少 Claude 会话,都得轮流坐这张桌子。git worktree 干的事很简单:给你再加几张桌子,每张桌子独立工作、共享同一个档案柜(.git)。
底层机制不复杂。你用 git worktree add 创建新目录时,Git 在 .git/worktrees/ 下写一份引用文件指向主仓库的 .git,然后做一次完整的文件 checkout。新目录有自己的 HEAD、自己的索引(staging area),但所有的 commit、branch、tag 操作都指向同一份对象数据库。无论你在哪个 worktree 里提交,git log 看到的是同一份历史。
git stash 再切分支,相当于把桌上东西塞进抽屉、换上别人的东西继续干。来回 pop、来回切,短期够用。但一旦同时要推进两个任务——一个在跑测试、一个在写代码——你只有一张桌子,两拨东西只能来回倒腾。worktree 给你开另一张桌子:自己的文件、自己的分支,和主工位共享同一个档案柜。改了新桌子的文件,主工位的文件完全不受影响;新桌子的改动提交后,在主工位也能看到。
本质区别:
| 方案 | 工作区数量 | 上下文模式 | 适合场景 |
|---|---|---|---|
| stash + 切分支 | 1 个,来回换 | 切换 | 短期、单线程 |
| 新分支 checkout | 1 个,切换 | 切换 | 同上 |
| git worktree | N 个,并行存在 | 并行 | 多任务、多会话、跨仓库 |
但工作区污染是被严重低估的问题。构建产物、依赖状态、IDE 索引、TypeScript 服务器缓存,全都绑在工作目录上。你切一次分支,npm 依赖可能就变了版本,IDE 缓存可能就脏了——上一个任务的环境被彻底搅乱。两个分支共享同一个工作目录,切换就是互相污染。这不是"分支管理"能解决的,你需要的是真正的物理隔离。
一行命令就能启动:
claude --worktree feature-auth
这行命令做三件事:在 .claude/worktrees/feature-auth/ 创建新目录、从默认分支拉出干净的 worktree-feature-auth 分支、把 Claude 会话的 cwd 切到新目录。你在另一个终端再跑一次换个名字,就是第二个独立工位。两个 Claude 会话可以同时运行,各自改各自的文件,互不干扰——这才是 stash 永远做不到的事。
也可以让 Claude 在会话内自己用 EnterWorktree 工具创建,适合中途发现需要隔离的场景。Desktop 用户更省心——每个新会话自动创建一个 worktree,天然隔离。
需要手动管理时,Git 原生命令也能用:
git worktree add ../project-feature -b feature-a  # 新建分支
git worktree add ../project-bugfix bugfix-123        # 已有分支
git worktree list                                    # 查看所有 worktree
git worktree remove ../project-feature               # 删除
打开终端跑
git worktree list。如果只返回一行,说明你的多个任务都在挤一张工位。
二、什么时候该用:项目类型决策矩阵
不是所有项目都需要 worktree。一个纯文档仓库,几个 Markdown 文件,stash 足够了。但如果你在开发前端项目——有 package.json、有构建系统、有 node_modules——上一章说的工作区污染就会变成你的日常。
隔离决策矩阵:
| 项目类型 | 判断标准 | 隔离方式 | 启动命令 |
|---|---|---|---|
| 前端/后端开发 | 有 package.json / pyproject.toml / 构建系统 | 强制 worktree | claude --worktree {name} |
| 配置/基础设施 | 改 yaml / json / 环境配置 | 临时 worktree | claude --worktree {name} |
| 知识库/文档 | 主要是 .md | 默认共享;跨项目联动时用 worktree | claude 或 claude --worktree |
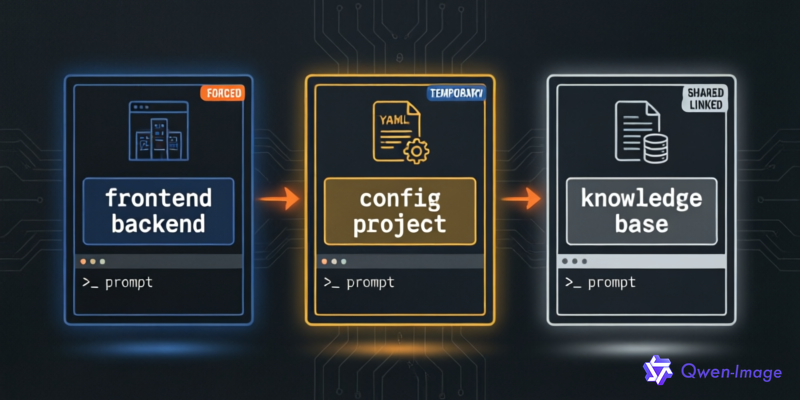
第三行有一个实战修正。原本我判断"知识库一律共享主目录就行"——纯文档项目确实不需要隔离。但实测发现,当你在改代码项目的同时需要更新知识库文档,跨项目联动时知识库也值得开 worktree。原因:你开了多个 Claude 会话,其中两个会话可能都需要改知识库的同一个文件——一个在更新接口文档,一个在补充部署说明。如果没有隔离,两个会话踩同一个文件,改动互相覆盖。
更具体的判断标准:如果你的知识库会经常被两个以上的需求会话同时编辑,就开 worktree。如果只是偶尔改改,共享主目录没问题。
命名规范也需要提前定。推荐格式 {module}-{story-id}-{feature},比如 auth-1055-login。为什么重要?当你开了四五个 worktree,git branch 列表里全是 worktree-bright-running-fox、worktree-temp-fix 这种默认名,你根本分不清哪个对应哪个需求。
三、实战四步:启动 → 配置 → 并行 → 清理
第一步:启动
最简启动:
claude --worktree feature-auth
省略名字会自动生成随机名(比如 bright-running-fox),适合临时任务。正式需求建议起有意义的名字,后面好认。从指定 PR 起步用 claude --worktree "#1234",Claude 会自动 fetch pull/1234/head 并创建 worktree。
注意一个前置条件:首次在某目录使用 --worktree 前,先跑一次 claude 接受 workspace trust。不跑的话会报错退出,提示你先执行 claude。这个坑很容易踩——你在一个新项目里第一次想用 worktree,直接 claude --worktree xxx,结果报错。
第二步:配置(两个关键)
baseRef。worktree 默认从 origin/HEAD(远端默认分支)拉出干净分支。这对开源项目或主干开发没问题,但企业项目通常基于 release/迭代分支开发,默认分支可能根本不是你的起点。
遇到这种情况,你需要修正起点。两种方式:手动 git reset --hard 到目标分支,或者设配置让默认从本地 HEAD 起:
{
  "worktree": {
    "baseRef": "head"
  }
}
baseRef 只接受 "fresh"(默认,从远端起)和 "head"(从本地 HEAD 起),不支持任意 ref。
.worktreeinclude。worktree 是全新 checkout,.env、.env.local 等 gitignored 文件不在新目录里。你在主工位配好的环境变量、密钥路径,worktree 里全没有。解决办法:在项目根目录创建 .worktreeinclude,语法同 .gitignore:
.env
.env.local
config/secrets.json
创建新 worktree 时,这些文件会自动复制进去。另外,别忘了在 .gitignore 里加上 .claude/worktrees/,避免 worktree 目录在主工位显示为未跟踪文件。
第三步:并行(核心亮点)
这是 worktree 真正发力的地方。实战场景:需求 X 需要同时修改两个前端工程(P1、P2)和更新知识库(K)的文档。
三个仓库,各开一个同名 worktree:
# 在项目 P1 目录
claude --worktree 需求X

# 在项目 P2 目录
claude --worktree 需求X

# 在项目 K 目录
claude --worktree 需求X
三个终端窗口并排,P1 改组件代码、P2 改关联适配逻辑、K 更新文档。三个会话各干各的,互不干扰。P1 的改动不会影响 P2 的文件系统,K 的文档编辑不会和任何一个代码项目冲突。
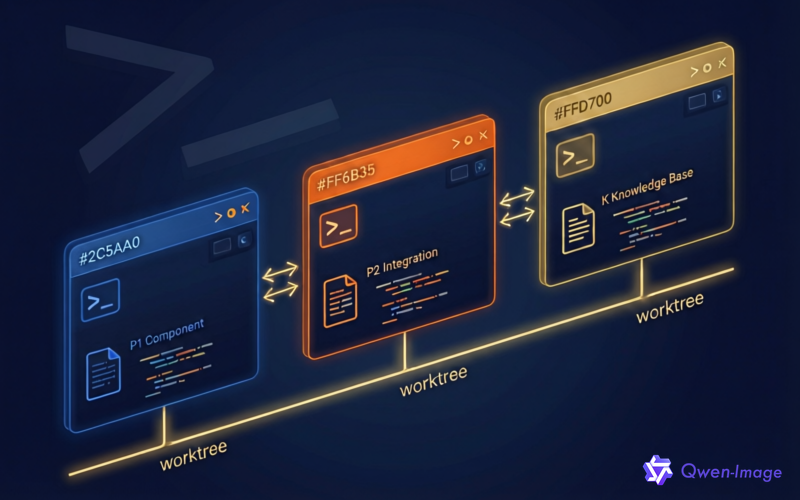
为什么同名?因为跨仓库场景下,同名让你一眼就知道这三个 worktree 服务于同一个需求。切换需求时,三个仓库一起切——关闭需求 X 的三个会话,打开需求 Y 的三个会话,心智负担最低。
同项目多需求并行也类似。实测中项目 P1 同时开了 4 个 worktree,推进 4 个不同需求。每个 worktree 有自己的分支、自己的依赖、自己的构建状态。切到哪个终端就是哪个需求,不需要 stash、不需要记住"我之前改到哪了"。4 个需求同时在线,随时切换,互不污染。
恢复会话用 /resume,然后 Ctrl+W 查看所有 worktree 会话。子 agent 要并行改文件的话,在 agent 定义里加 isolation: worktree,每个子 agent 会获得自己的临时 worktree,完成后自动清理。
第四步:清理
退出 worktree 会话时的清理规则:
- 无未提交改动:worktree 和分支自动删除
- 有未提交改动或新提交:Claude 会提示你选择 keep 或 remove
- 非交互运行(
--worktree+-p):不自动清理,需手动git worktree remove
手动管理命令:
git worktree list          # 查看所有 worktree
git worktree remove <path> # 删除指定 worktree
推荐一个清理 SOP:确认无未提交改动 → 提交推送建 PR → 合并后 git worktree remove → 删本地分支。不要等,合并完立刻清理。
四、五个真实踩坑
以下是我在实际项目中踩过的坑,每一条都有实测数据佐证。建议读完后对照自己的项目自查一遍。
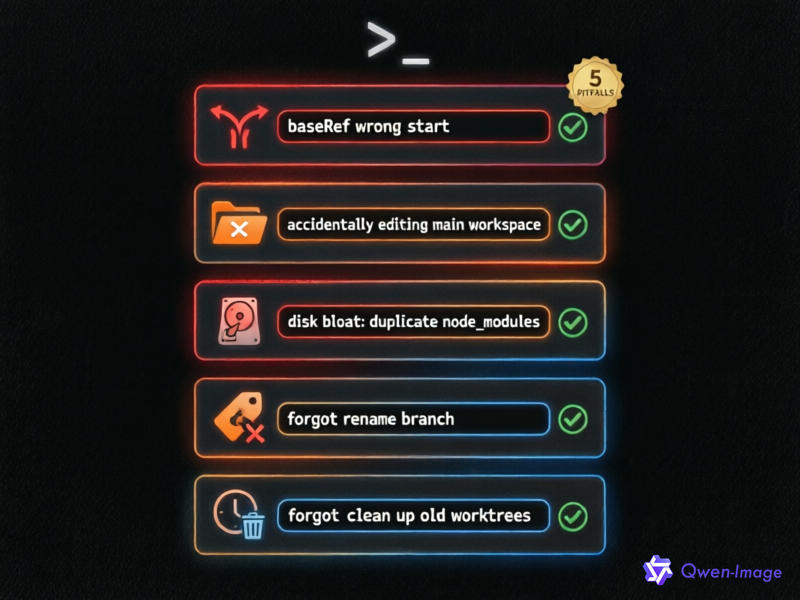
坑 1:baseRef 默认从 main 起,企业项目要手动修正
我用 EnterWorktree 创建 worktree,默认从 origin/main 拉出干净分支。但我们的项目要从 release 迭代分支起步——默认分支压根不是开发基线。创建完后只能手动 git reset --hard 到目标分支,再 git branch -m 改分支名。
教训:默认行为适合开源或主干开发。企业迭代开发项目,创建 worktree 后先确认起点分支对不对。
坑 2:cwd 切回主目录,误改了主工作区文件
这是一个很隐蔽的坑。会话的 cwd 一度切回了主项目根目录——我在主工位上改了配置文件,以为是在 worktree 里改的。结果 worktree 的配置和主工位的配置基于不同分支,版本完全不同,事后发现两边都不一致,只能分别还原和重改。
worktree 和主工作区共享 .git 但文件完全独立。改了这边不影响那边——这既是优势,也是陷阱。
worktree 不是分身,是另一张桌子。你以为改的是同一份文件,其实是两张桌子上的两个副本。
坑 3:磁盘膨胀——每份 worktree 都有自己的 node_modules
实测数据:项目 P1 开了 4 个 worktree,磁盘总占 3.8GB。而一个"裸 checkout"(未装依赖的 worktree)只有 9.3MB。
膨胀全来自各自独立的 npm install。每个 worktree 都跑了一遍依赖安装,四个 worktree 就有四份几乎一样的 node_modules。
应对:用完即清,控制并行 worktree 数量。monorepo 项目可以用 pnpm 的共享 store 和硬链接缓解。如果你不需要在 worktree 里跑构建,干脆不装依赖——9.3MB 的裸 checkout 完全够 Claude 读懂代码和改文件。
坑 4:知识库 worktree 忘了改分支名
开发项目 P1 和 P2 的 worktree 分支都按企业命名规范起了,但知识库 K 的 worktree 还是 EnterWorktree 生成的默认名——worktree-xxx。
问题不大,但在 git branch 列表里一眼就能看出命名不统一。企业项目有分支命名规范时,创建 worktree 后一定要检查分支名是否需要 rename。
教训:知识库项目最容易漏改,因为它不像开发项目那样频繁操作分支,改名这件事更容易忘。
坑 5:用完不清,旧 worktree 残留
实测 7 月 20 日快照:项目 P1 的 4 个 worktree 中,2 个是当天活跃的,另外 2 个是 7 月 16 日创建的旧需求 worktree。两个旧 worktree 都没有未提交改动,可以安全删除——但一直留着没清。
四天不算长,但如果每个项目都积攒几个"忘了删"的 worktree,磁盘占用会悄悄膨胀,git worktree list 的输出也会变得混乱。
教训:需求合并后立刻按清理 SOP 删除 worktree 和分支。定期跑 git worktree list 巡检,发现过期 worktree 及时清理。
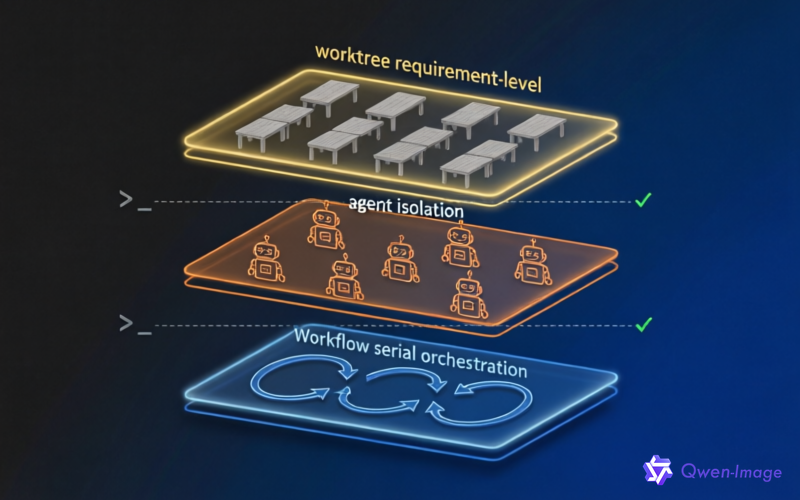
五、进阶:worktree × Workflow × 子 agent,三层隔离的边界
当你开始把 worktree 和 Claude Code 的 agent 体系结合使用,会碰到一个容易混淆的问题:这三层隔离到底各管什么?什么时候该用哪一层?
用一个实战场景来说明。需求 W 是一个相对独立的模块,我在外层给它开了一个 worktree(一个独立工位)。在这个 worktree 里,跑一个 Workflow 编排三个 agent 做迭代循环:Playwright 自动测试 → 根据测试结果改代码 → 检视改动质量,最多循环三轮,每轮用 schema 约束结构化输出。
看起来有好多层隔离,但每一层解决的问题是不同的:
| 隔离层 | 解决的问题 | 何时使用 |
|---|---|---|
| worktree(需求级) | 多个需求在同一仓库并行时的文件冲突 | 多任务同时推进、跨仓库需求并行 |
isolation: worktree(agent 级) | 多个子 agent 同时改不同文件时的冲突 | 子 agent 并行改文件 |
| Workflow 串行 | 同一需求内多步骤的流水线编排 | 测→改→检视等顺序流程 |
这里有一个反直觉的洞察,很多人会搞错:
同一需求的多个 agent 是串行工作的,不需要各自开 worktree。
为什么?因为串行无冲突。Agent A 测完了输出结果,Agent B 拿到结果改代码,Agent C 检视改动——它们在同一个文件系统上依次操作,共享文件状态,这正是你想要的。如果每个 agent 都开自己的 worktree,Agent A 改的文件 Agent B 反而看不到,协作就断了。
worktree 的真正价值是并行需求隔离,不是 agent 隔离。它的核心场景是"需求 X 和需求 Y 同时改同一个仓库"——这才是文件冲突真正发生的地方。
同理,Workflow 是串行编排器,不是并行调度器。agent() 调用是 await 串行的——一个跑完再跑下一个。如果你需要真并行,得在主会话同一轮 spawn 多个 Agent 调用,但实际场景中用得很少,因为大多数多步骤流程天然是顺序的。
最后,agent 协作可靠的关键是 schema 约束结构化输出。比如让测试 agent 输出 issues、fixed、passed 三个结构化字段,比让它输出自由文本再由下一个 agent 解析要可靠得多。结构化输出是 agent 之间传递信息的最小可靠单元。
落地:写进 CLAUDE.md
三件事,五分钟写完,立刻生效。在开发项目 CLAUDE.md 里加一节"多会话隔离":有构建系统的项目多会话必须用 claude --worktree 启动,禁止多个会话共享主目录做开发,附命名规范({module}-{story-id}-{feature})和清理 SOP。在项目根目录创建 .worktreeinclude,把 .env、.env.local 等必要配置文件带进新 worktree。自查一句话:新会话能引导你用 worktree、两个 dev 会话互不冲突、分支命名符合规范——这三条全过,你的隔离体系就到位了。
行动清单
打开终端跑
git worktree list——如果只返回一行,说明你的多个任务都在挤一张工位。
一张桌子一个人,N 张桌子一个团队。worktree 不是工具,是并行工作的思维方式。
互动话题
你平时怎么处理多任务并行的?是 stash 切换来去,还是已经用上了 worktree?遇到过什么"多会话打架"的囧事?来评论区聊聊。
参考文献
- Git 官方文档,"git-worktree",https://git-scm.com/docs/git-worktree
- Claude Code 官方文档,"Run parallel sessions with worktrees",https://code.claude.com/docs/en/worktrees
- Claude Code 官方文档,"Run agents in parallel",https://code.claude.com/docs/en/agents
本文内容仅供学习交流,所述方法需结合实际场景灵活运用。 AI工具输出结果仅供参考,关键业务决策请结合人工判断。
本文由AI辅助创作,经人工审核编辑后发布。
本文首发于微信公众号「羲和Lab」,公众号内可留言交流
阅读公众号原文