AI岗位说明书:CLAUDE.md精讲
约 21 分钟驭光者首发于微信公众号「羲和Lab」
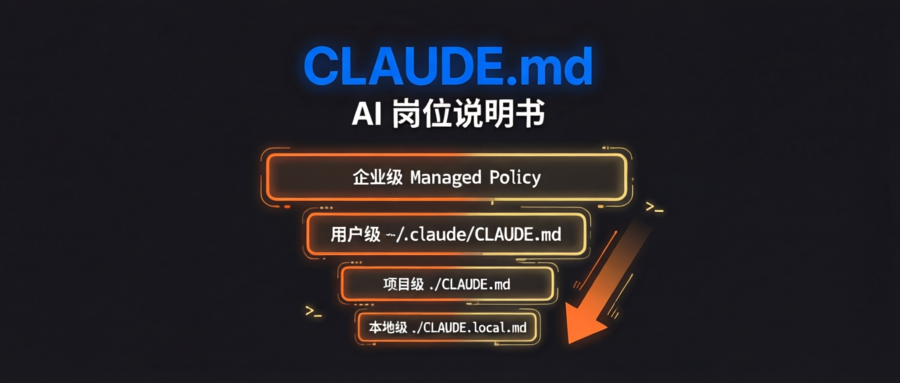
写好这份"说明书",AI每次开工就不用你再说废话
阅读时长约10分钟 | 教程型 | 智能编码进化论 02/10
导读
上一篇我们搞清楚了Agent和补全工具的本质区别——Agent不是更聪明的补全,而是一个能自己看项目、自己动手、自己验证的协作者。你的角色从"司机"变成了"副驾驶"。
但有个问题没解决:你每次开新会话,都要重复告诉AI同样的规则——"用pnpm别用npm"、"测试文件放在源文件旁边"、"API返回统一格式"。说一遍两遍还好,说十遍你就开始怀疑人生了。
CLAUDE.md就是解决这个问题的。把它理解成你给AI实习生准备的岗位说明书——写一次,每次开工它自动看。
一、先说结论:CLAUDE.md是什么
一句话定义:CLAUDE.md是Claude Code每次启动时自动加载的项目配置文件。
不是提示词,不是系统指令,是配置文件。区别在哪?提示词是你每次手动输入的,配置文件是系统自动读取的。你不需要在每次会话开头重复"请使用2空格缩进"、"本项目用pnpm",只要这些规则写在CLAUDE.md里,Agent每次启动自动就知道。
具体来说,当你在项目目录下运行claude命令时,Claude Code会按固定规则加载一系列配置文件,CLAUDE.md就是其中最核心的一个。它的内容会被注入到Agent的上下文中,作为它理解项目和执行任务的基础信息。
一个典型的CLAUDE.md长这样:
# 项目约定

## 命令
- 构建:`npm run build`
- 测试:`npm test`
- 代码检查:`npm run lint`

## 技术栈
- TypeScript严格模式
- React 19,仅使用函数组件
- Tailwind CSS用于布局,Ant Design用于UI组件

## 规则
- 使用命名导出,禁止默认导出
- 测试文件放在源文件旁边:`foo.ts` -> `foo.test.ts`
- 所有API路由返回 `{ data, error }` 统一格式
就这些。没有花哨的prompt工程技巧,没有复杂的指令框架。就是把项目的客观事实写下来:用什么技术、怎么构建、有什么规则。Agent读完后,就知道该怎么在这个项目里干活了。
和提示词的根本区别:提示词是一次性的对话输入,CLAUDE.md是持久化的项目配置。 你不需要每次重复,Agent也不需要每次猜测。
上一篇最后说:"范式已经变了,还用'怎么写好提示词'的思路来驾驭Agent,就像用骑自行车的经验去开汽车。"CLAUDE.md就是那本新的"驾驶手册"。
二、四级作用域:从企业到个人
岗位说明书不是只有一份。一个大公司,会有集团级制度、部门级规范、岗位级要求、个人工作习惯。CLAUDE.md的体系也一样,分四级。
企业级:Managed Policy
位置:/Library/Application Support/ClaudeCode/CLAUDE.md(macOS)
这是IT部门统一部署的全局配置,所有员工、所有项目的Agent都会遵守。比如公司规定"代码必须通过内部代码仓库拉取"、"禁止访问外部付费API",这些规则写在这里,任何人都无法绕过。
这一级一般由技术管理员通过企业部署工具推送,个人开发者不用操心。但你需要知道它的存在——如果你的Agent突然说"公司策略禁止此操作",就是这层配置在起作用。
企业级配置普通开发者通常接触不到,但从下一级开始,就是你自己的地盘了。
用户级:你的个人偏好
位置:~/.claude/CLAUDE.md
这是你的个人偏好,对所有项目生效。就像你不管去哪个项目,习惯用中文交流、习惯2空格缩进、习惯用pnpm——这些属于你个人的编码习惯,不依赖具体项目。
举个例子,我在用户级CLAUDE.md里写了这些:
# 个人偏好

## 语言
- 优先使用中文交流
- 响应风格简洁直接

## 工作环境
- 项目管理:TAPD
- 源码控制:GitHub

## 常用工具
- TAPD MCP:需求、缺陷、任务管理
- Playwright MCP:网页自动化测试
无论我打开哪个项目,Agent都知道我偏好中文、用GitHub管理代码、用TAPD管需求。这些信息不需要在每个项目里重复写一遍。
项目级:团队共享规范
位置:项目根目录下的 ./CLAUDE.md 或 .claude/CLAUDE.md
这是核心。项目级配置写的是这个项目特定的规则,提交到git,团队所有人共享。技术栈选择、目录结构约定、命名规范、构建命令——凡是团队成员需要遵守的,都写在这里。
# CLAUDE.md

## 技术栈
- React 19 + TypeScript 6 + Vite 8
- pnpm作为包管理器
- Ant Design v6(UI组件)+ Tailwind CSS v3(布局)
- React Query v5(服务端数据)+ MobX 6(客户端状态)

## 规则
- verbatimModuleSyntax: true,类型必须 import type
- 不用 enum,用 const 对象 + type
- API响应字段统一转 CamelCase
- 分页响应格式:{ list: T[], total: number, page: number, pageSize: number }
团队里每个开发者运行claude命令时,Agent都会自动读取这份配置。新成员加入项目,他的Agent立刻就知道项目的技术栈和规范,不需要老手口口相传。
本地级:个人项目偏好
位置:./CLAUDE.local.md
这一级解决一个现实问题:团队规范是统一的,但个人习惯各有不同。有人喜欢用VS Code,有人习惯用WebStorm;有人在本地跑了特殊的测试环境,端口不是默认的。这些不影响项目规范但影响个人体验的配置,写在这里。
关键是:CLAUDE.local.md不提交到git。 它只存在于你的本地环境,不影响团队其他成员。.gitignore里通常会把CLAUDE.local.md排除掉。
# 个人本地配置

- 本地开发服务器端口:3001(避免与主项目冲突)
- 代码检查:提交前运行 lint
- 测试命令:`npm run test:local`(使用本地数据库)
四级优先级
加载顺序是:企业级 → 用户级 → 项目级 → 本地级。后加载的优先级更高,可以覆盖前面的规则。
这很合理。公司说"用npm",但项目组决定"用pnpm",那项目级的pnpm指令会覆盖公司级的npm。个人在本地又改了测试命令,本地配置又覆盖了项目配置。
记住一条原则:越具体的配置,优先级越高。
三、编写实战:怎么写出好用的CLAUDE.md
理论说完,动手。
/init:一键生成起点
手动从零写CLAUDE.md容易不知道该写什么。Claude Code提供了一个/init命令,自动分析你的代码库,生成初始版本。
# 进入项目目录
cd your-project

# 启动 Claude Code
claude

# 在 Claude Code 里输入
/init
/init会扫描项目结构、读取package.json、分析技术栈、识别构建工具和测试框架,然后生成一份初始CLAUDE.md。如果项目里已经有了CLAUDE.md,它会建议改进方案。
想体验更完整的交互式流程,可以设置环境变量:
CLAUDE_CODE_NEW_INIT=1 claude
这样启动后/init会进入多阶段模式,分步骤确认每个部分的内容,而不是一次性全部生成。
编写原则:四条铁律
第一,控制长度,200行以内。
CLAUDE.md的内容会被注入到Agent的上下文窗口中。写得太长,占用大量token,反而会降低Agent理解关键信息的效率。200行是一个务实的上限——如果你的配置超过这个长度,说明有些内容应该拆到.claude/rules/目录里(后面会讲)。
第二,写具体可验证的指令。
| 差 | 好 |
|---|---|
| "代码格式要规范" | "使用2空格缩进,单引号,行尾无分号" |
| "注意命名规范" | "组件用PascalCase,工具函数用camelCase,常量用UPPER_SNAKE_CASE" |
| "写好注释" | "只在WHY不明显时添加一行简短注释,不解释WHAT" |
模糊的指令Agent只能猜,猜错就是你的问题。具体的指令Agent可以直接执行,结果可验证。
第三,用标题和列表组织内容。
Agent读markdown格式的配置文件,结构清晰很重要。用##分成几个大块(技术栈、规则、命令),每块内部用列表或表格呈现。不要写大段散文。
第四,定期审查,删过时内容。
项目在演进,规则在变化。三个月前写的"本项目使用JavaScript"现在可能已经切换到TypeScript了。不更新的CLAUDE.md比没有更危险——Agent会按过时规则执行。
5分钟最小版本
别急着写60行的完美配置。先写一个5行版本:
# CLAUDE.md
- 包管理器:pnpm(不是npm)
- 构建:`pnpm build`
- 测试:`pnpm test`
- 代码风格:2空格缩进,单引号,无分号
这就够了。Agent至少不会用错包管理器,不会跑错命令。其他规则可以在使用中逐步添加——等你第二次手动纠正Agent同一个错误时,再把那条规则加进去。
一个完整的实战示例
假设你接手了一个React前端项目,技术栈是React + TypeScript + Ant Design,后端用FastAPI。一份比较完整的CLAUDE.md可以这样写:
# CLAUDE.md

## 项目概述
前端管理后台,基于 React 19 + TypeScript + Ant Design v6。
后端 API 通过 Vite proxy 转发到 FastAPI 服务。

## 命令
- `pnpm dev` — 启动开发服务器
- `pnpm build` — 生产构建
- `pnpm lint` — ESLint 检查
- `pnpm test` — 运行测试

## 技术栈
- React 19 + TypeScript 6(strict mode)
- Vite 8 构建,pnpm 包管理
- Ant Design v6 — UI 组件(主题通过 Design Token 配置)
- Tailwind CSS v3 — 仅布局间距,不覆盖 Ant Design 样式
- React Query v5 — 服务端数据管理
- MobX 6 — 全局客户端状态

## 编码规则
- `verbatimModuleSyntax: true`,类型必须用 `import type`
- 不使用 `enum`,用 `const` 对象 + `type` 代替
- 组件使用函数组件 + hooks,不写 class 组件
- API 响应字段统一转 CamelCase
- 分页格式:`{ list: T[], total: number, page: number, pageSize: number }`
- 命名导出优先,禁止默认导出

## 目录结构
- `src/features/` — 按业务模块组织
- `src/features/<模块>/index.tsx` — 页面入口
- `src/features/<模块>/components/` — 模块内组件
- `src/features/<模块>/hooks/` — React Query hooks
- `src/services/` — API 请求层
- `src/stores/` — MobX stores

## 注意事项
- Tailwind preflight 必须关闭(不引入 `@tailwind base`)
- 覆盖 Ant Design 样式时使用 Less `:where()` 降低优先级
- 不可逆操作必须二次确认(删除、强制推送等)
大约60行,信息密度高,Agent读完后对这个项目的了解比大多数新成员第一周还多。
四、高级用法:rules条件加载与Auto Memory
.claude/rules/:按需加载,减少噪音
前面说CLAUDE.md要控制在200行以内。但一个复杂项目,规则可能远超这个数量。怎么办?
.claude/rules/目录提供了一种条件加载机制。规则文件写在这里,Agent不会在启动时全部加载,而是根据你当前正在编辑的文件类型和目录,按需加载相关规则。
规则文件就是一个带前置元数据的markdown文件:
---
paths:
  - "src/api/**/*.ts"
---
# API 开发规则

- 所有 API 端点必须包含输入验证
- 使用统一的错误响应格式 `{ code, message, data }`
- 分页接口必须返回 total 字段
paths字段指定了这条规则的生效范围。当Agent在操作src/api/目录下的.ts文件时,这条规则才会被加载。当你在写src/components/里的UI组件时,这条规则不会占用上下文。
再举一个例子:
---
paths:
  - "src/stores/**/*.ts"
---
# MobX 状态管理规则

- Store 使用单例模式,直接 import,不需要 Provider
- 组件使用 `observer` HOC 包裹
- 异步操作放在 Service 层,Store 不直接发请求
- 计算属性用 `computed`,不要在组件里派生
这个规则只在编辑store文件时加载。写UI组件的时候完全不占token。
好处很明显:Agent的上下文窗口始终聚焦在当前任务相关的规则上,不被无关信息干扰。 项目有50条规则,当前操作只涉及其中3条,上下文里就只有这3条。
Auto Memory:Agent自己的笔记本
CLAUDE.md是你写给Agent的,Auto Memory是Agent写给自己的。
开启Auto Memory后,Claude Code会自动在~/.claude/projects/<项目路径>/memory/目录下记录它的工作笔记。比如它发现项目里有一个特殊的配置文件用途、或者记住你上次纠正过的一个错误——这些信息会被自动保存。
memory目录里有一个MEMORY.md索引文件。每次会话开始时,Claude Code会加载这个索引文件的前200行或25KB内容(以较小者为准),快速恢复对项目的"记忆"。具体的主题笔记则按需读取。
举个例子,Auto Memory可能记录了这样的内容:
# MEMORY.md

## 项目关键发现
- 项目的API网关配置在 `src/gateway/index.ts`,不是常见的 `server.ts`
- 数据库迁移使用 Alembic,迁移文件在 `alembic/versions/`
- 环境变量使用 `.env.local` 文件,不使用 `.env`

## 用户纠正记录
- 用户偏好:修复Bug时不要同时做无关的重构
- 用户偏好:提交信息用中文描述
这些信息不是你手动写的,是Agent在多轮交互中自动积累的。下次你开新会话,它会先读MEMORY.md,快速恢复对项目的理解。
Auto Memory是v2.1.59版本后的默认行为。 如果你用的是较新版本的Claude Code,这个功能已经自动开启了,不需要额外配置。
CLAUDE.md和Auto Memory的分工:CLAUDE.md是你主动定义的静态规则(项目不会突然换技术栈),Auto Memory是Agent自动积累的动态发现(运行中发现的隐藏配置、用户偏好)。前者是"岗位说明书",后者是"工作笔记"。
两层知识架构:Agent的知识管理分两层——静态层(你写好的规则)和动态层(Agent自己积累的经验)。两层互补,缺一不可。只有CLAUDE.md,Agent不懂变通;只有Auto Memory,每次新会话都要重新摸索。两者配合,Agent才能像一个既了解规则又有经验的同事一样工作。
五、避坑指南
坑一:写得太长,Agent反而变笨
最容易犯的错误就是往CLAUDE.md里塞太多东西。有人把整个项目的README、架构文档、部署指南全搬进去,结果就是Agent的上下文窗口被大量低频信息占满,真正重要的规则反而被淹没。
200行是上限,不是目标。 实际上,大多数项目的有效配置在50-100行之间就够了。
超过200行的内容,拆到.claude/rules/里做条件加载。实在不舍得删的,放到项目wiki或文档目录里,需要的时候让Agent去读。
坑二:/init生成的结果不完全可靠
/init分析的是代码库的静态信息,有些"潜规则"它发现不了。比如团队有个不成文的约定"不写class组件",这个约定不体现在任何配置文件里,/init不会自动加上去。
正确的用法是把/init当成起点,手动补充它看不到的内容。 生成后逐项检查,加上团队约定、个人偏好、注意事项等/init无法自动识别的规则。
坑三:不同级别的配置冲突
如果你在用户级写了"使用ESLint标准配置",项目级写了"使用@antfu/eslint-config",项目级的会覆盖用户级。这可能不是你想要的结果——你个人习惯和项目规范都成立,但Agent只会按项目级来。
遇到这种情况,检查优先级是否合理。如果某个规则确实需要在所有项目中生效,就不要在项目级覆盖它。如果项目级必须覆盖,确保是团队共识。
坑四:提交了不该提交的配置
CLAUDE.local.md是你的个人配置,不要提交到git。在.gitignore里加上:
CLAUDE.local.md
.claude/CLAUDE.local.md
如果你不小心提交了包含本地路径、个人token或特殊配置的CLAUDE.local.md,赶紧从git历史里清理掉。
结语
上一篇的结尾留了一句话:"你的任务,从'操作它'变成了'配置它'。"
CLAUDE.md就是"配置它"的第一步。
过去你和AI编程工具的协作方式是每次重复——每次会话都从头教它项目的规则。现在变成了一次配置,长期生效。你把项目的规则写进配置文件,Agent每次启动自动读取,像一个真正熟悉项目的同事一样开始工作。
更妙的是,这份配置是可以演进的。你今天发现一条规则没写清楚,明天加上;团队今天决定切换构建工具,明天更新配置;Agent自己发现了项目里隐藏的约定,通过Auto Memory记下来。整个系统的"知识"在不断积累,而维护成本几乎为零。
这就是"岗位说明书"的力量。一个好的实习生,给他一份清晰的岗位说明书,他就能快速上手。一个优秀的Agent,给它一份准确的CLAUDE.md,它就能在项目里高效工作。
从下一篇开始,我们进入实战层面:怎么像一个带实习生的老手一样,高效地和Agent交互。任务怎么拆、问题怎么问、什么时候该干预、什么时候该放手——下一篇,像带实习生一样带AI。
互动话题
你的项目里有没有一些"不成文的规矩"——团队都知道但没有写在文档里的约定?这些约定如果让AI也知道,会不会省下不少重复解释的时间?来评论区聊聊。
智能编码进化论 | 第2篇/共10篇
上一篇:别再教AI了,让它自己看项目
下一篇:像带实习生一样带AI:任务与工作流
本文内容仅供学习交流,所述方法需结合实际场景灵活运用。 AI工具输出结果仅供参考,关键业务决策请结合人工判断。
本文由AI辅助创作,经人工审核编辑后发布。
本文首发于微信公众号「羲和Lab」,公众号内可留言交流
阅读公众号原文